モデル
新しいセッションで使うメインモデル、障害時の代替モデル、補助タスク用モデル、複数モデルを組み合わせるエージェントの協調(MoA)を設定する。複数のプロファイルを持つ環境では、画面上部に「適用対象」チップが表示され、どのプロファイルの設定を編集するかを選べる(プロファイルが 1 つだけなら表示されない)。
設定サイドバーの「モデル」を選ぶと、次の 4 つの子項目が開く。画面を開いた直後は先頭の「メインモデル」が表示される。各ページの上部にはパンくず(例: 設定 > モデル > 補助モデル)が出る。
| 子項目 | 主な内容 |
|---|---|
| メインモデル | プロバイダーとモデル、推論レベル・速度の既定、コンテキストウィンドウの上書き |
| 代替モデル | メインモデルが失敗したときに試すフォールバックモデル |
| 補助モデル | 圧縮・ビジョン・承認などの補助タスクに使うモデルと推論強度 |
| エージェントの協調 | 複数モデルの助言を集約する Mixture of Agents(MoA)プリセット |

メインモデル
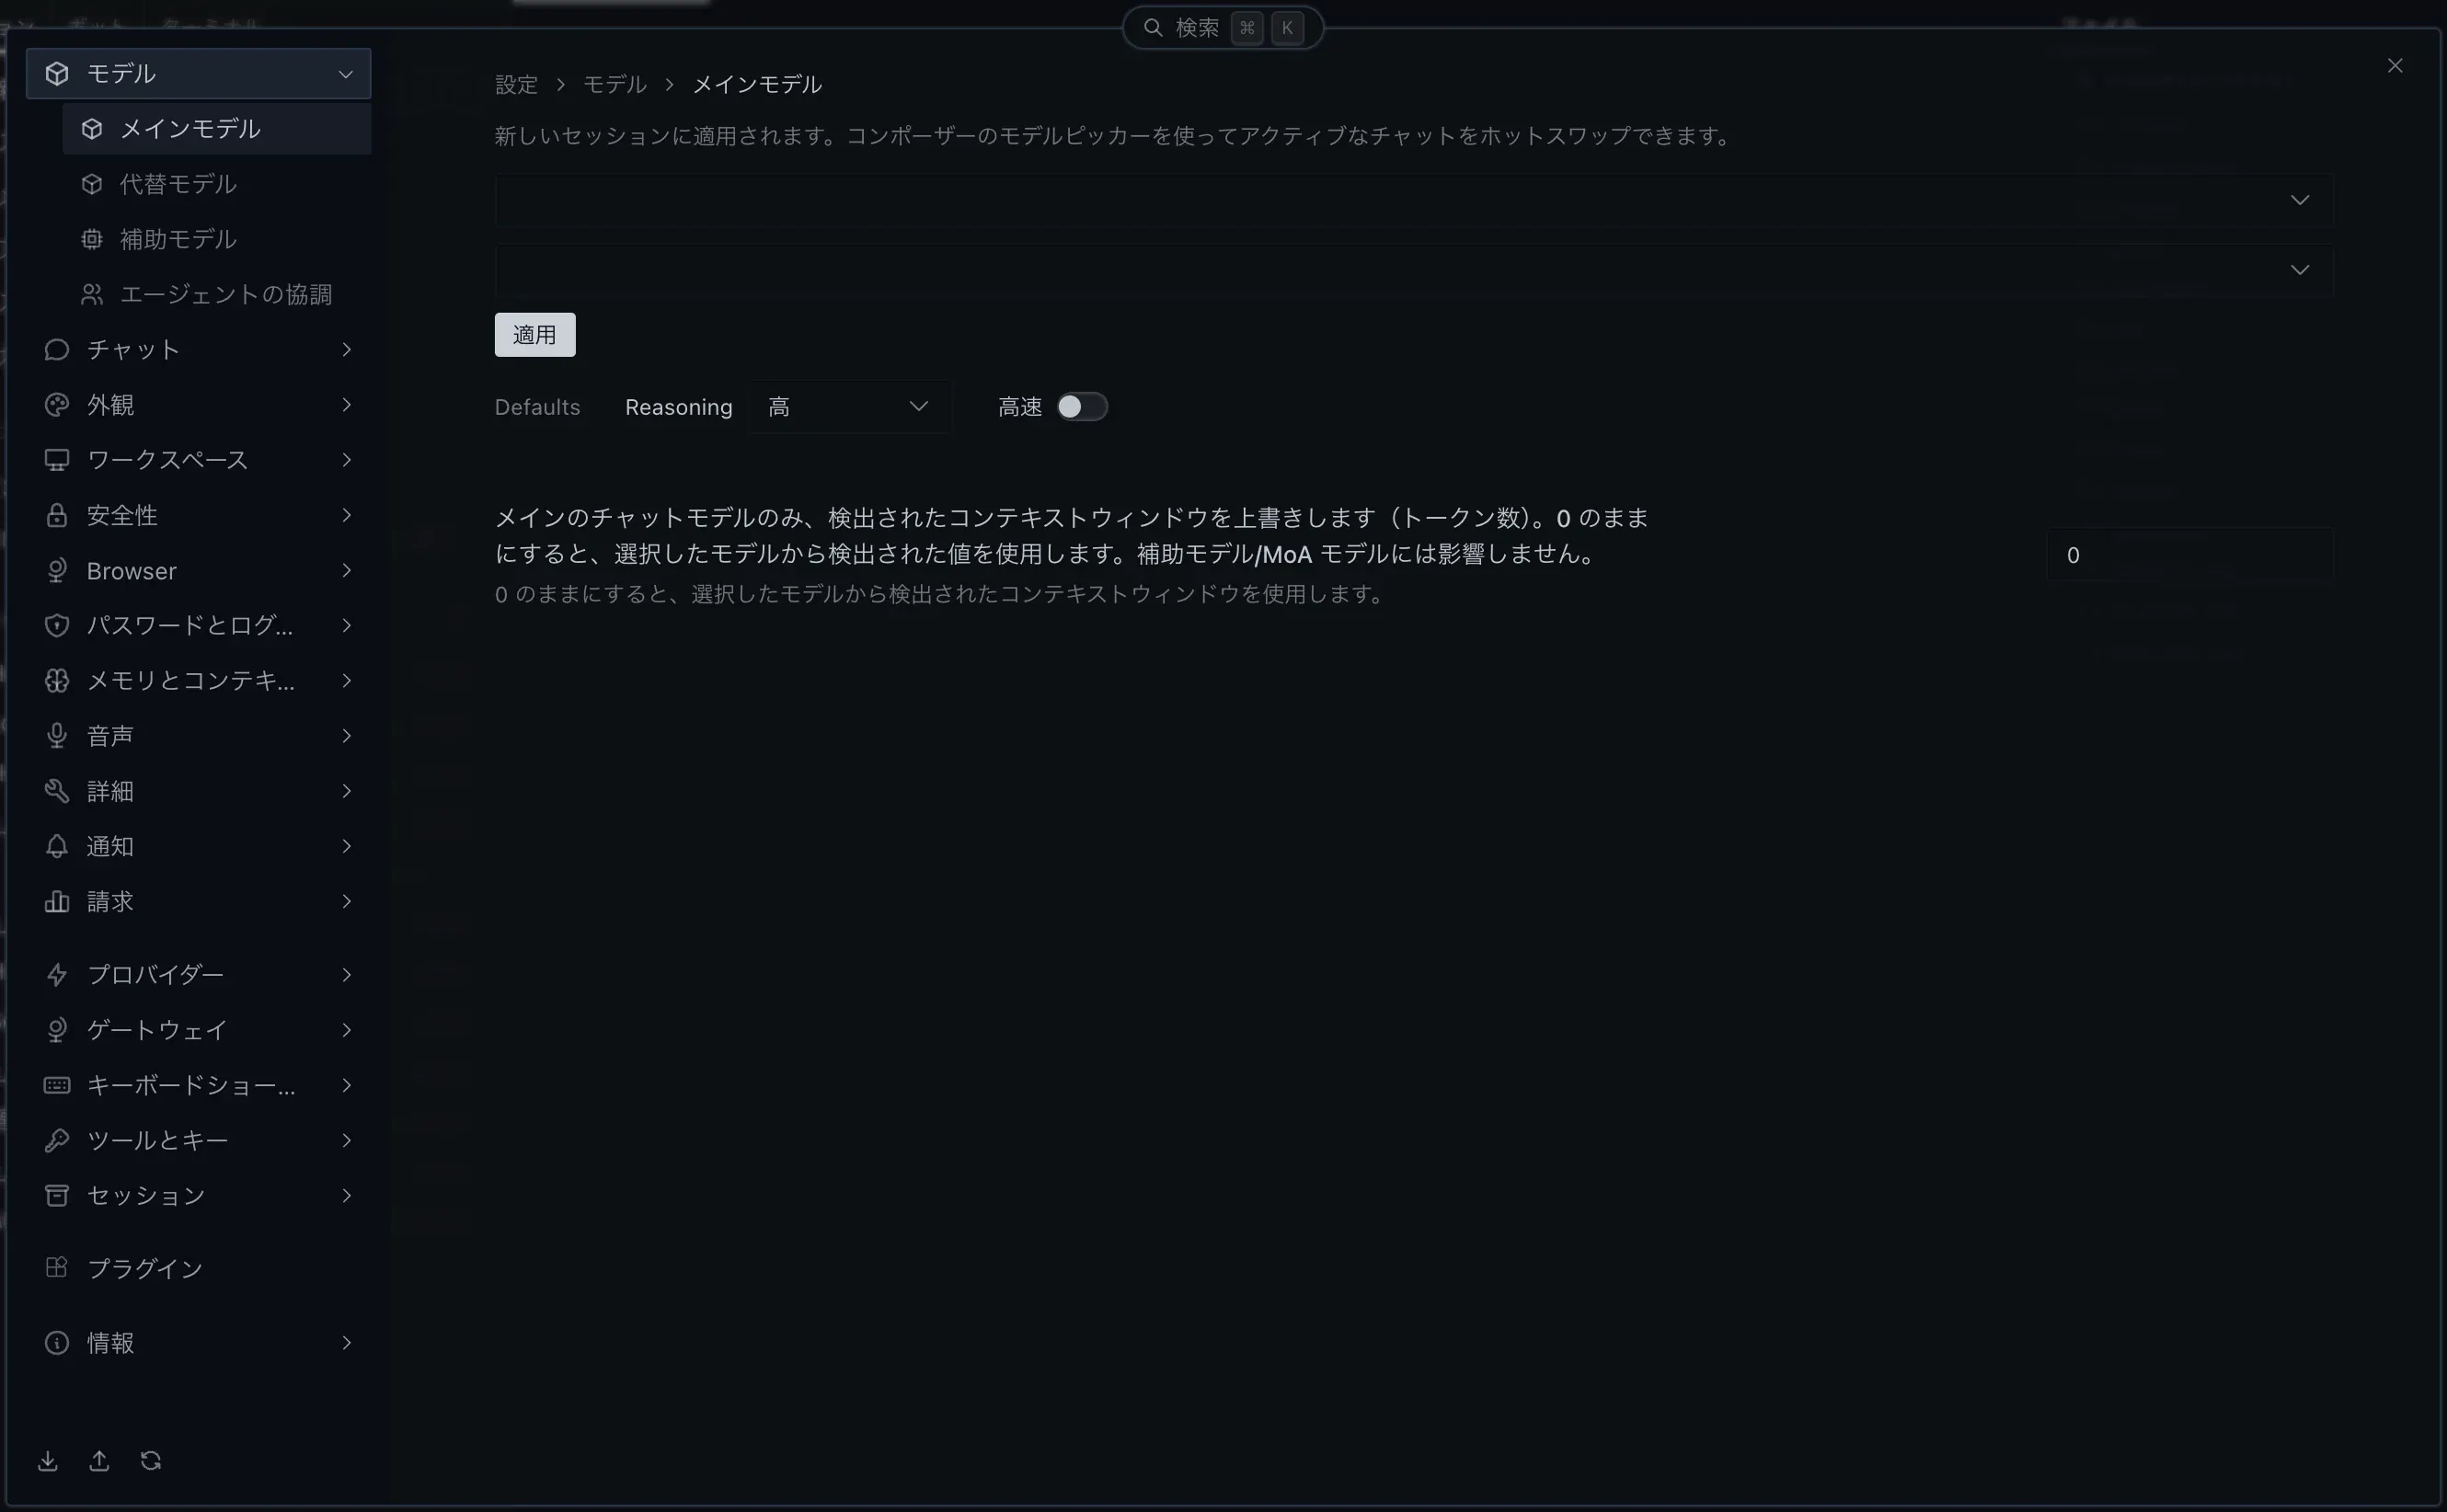
Section titled “メインモデル”ページ冒頭には「新しいセッションに適用されます。コンポーザーのモデルピッカーを使ってアクティブなチャットをホットスワップできます。」と表示される。
| 画面表示(主) | 内部キー(サブ) | 内容 | 製品既定値 | 推奨 |
|---|---|---|---|---|
| プロバイダー | model.provider | 認証済みプロバイダーを選択 | 未設定 | 普段使う契約・API を1つ選ぶ |
| モデル | model.default | 選択プロバイダーのモデル。一覧末尾の「カスタムモデル…」で ID を手入力できる | 未設定 | ツール呼び出し対応モデル |
| 適用 | model.provider + model.default を保存 | 選択内容を新規セッション用に保存 | - | 変更後に必ず押す |
メインモデルの変更は 「適用」ボタンが必要。新しいセッションに反映される。適用すると英語のトースト「Main model updated」が表示される(日本語リソース未整備のため英語表示)。
- カスタムモデル ID: モデル一覧に目的のモデルが無いときは「カスタムモデル…」を選び、「モデル ID」欄に ID を入力して確定する。確定した ID はカスタムモデルとして記憶される。「リストから選択」で一覧へ戻れる。この入力方式は代替モデル・補助モデル・エージェントの協調のモデル欄でも共通。
- プロバイダーの切り替え: プロバイダーを手動で切り替えると、前のプロバイダーで選んでいたモデルは持ち越されない。切り替え後のプロバイダーからモデルを選び直す。進行中のチャットは、コンポーザーのモデルピッカーからホットスワップできる。1ターンだけ別モデルで実行して自動的に元へ戻す
/model --onceもある(コスト面の注意は スラッシュコマンド一覧 を参照)。
未認証の API キー型プロバイダーでは、その場でキー入力が表示される。OAuth 型はブラウザーサインインへ移動する。
選択肢が動的である項目
Section titled “選択肢が動的である項目”プロバイダーとモデルの候補は固定リストではない。次の情報から実行時に生成される。
- アカウントまたは API キーで接続したプロバイダー
- 各プロバイダーが現在公開しているモデルカタログ
- Hermes が持つモデルメタデータとキャッシュ
- ローカルまたはカスタムエンドポイントの検出結果
このため、モデル名を静的に「全一覧」として固定すると短期間で古くなる。本ノートでは画面の全操作と選択規則を網羅し、実際のモデル候補はその時点のドロップダウンを正とする。
モデルピッカーの表示
Section titled “モデルピッカーの表示”デスクトップのモデルピッカーには、次の表示上の仕組みがある。
- プロバイダーグループの折りたたみ: デスクトップのモデルピッカーでプロバイダー名の行をクリックすると、そのグループを折りたたみ・展開できる。検索中と、現在使用中のモデルのプロバイダーは常に展開される。
- 同一ベンダーのエンドポイント統合: 同じベンダーの複数エンドポイント(グローバル API・中国 API・OAuth プランなど)は1つのグループ行にまとまる。Qwen(Qwen Cloud / DashScope・Coding Plan・Qwen CLI OAuth)のほか、Kimi、MiniMax、xAI、OpenAI、OpenCode、GitHub Copilot などが対象。表示のみの変更で、
provider:model形式での個別指定はそのまま使える。 - 価格タグ: 価格情報を取得できるプロバイダー(OpenRouter・Nous・Novita・DeepInfra・Fireworks)では、モデル名の横に入力/出力の単価(100万トークンあたり USD)が表示される。
推論レベルと速度(Defaults ブロック)
Section titled “推論レベルと速度(Defaults ブロック)”メインモデルの直下にある Defaults ブロックで、新しいセッションの既定の推論レベル(reasoning effort、行名は「Reasoning」)と速度を選ぶ。推論レベルは適用中のメインモデルが推論に対応している場合だけ表示される。選択肢は 8段階ある。
| 画面表示(主) | 保存値(内部 agent.reasoning_effort) | 既定 | 内容 |
|---|---|---|---|
| Off | none | いいえ | 推論(思考)を行わない |
| 最小 | minimal | いいえ | 最小限の推論 |
| 低 | low | いいえ | 低い推論強度 |
| 中 | medium | はい | 標準の推論強度。未設定時の製品既定 |
| 高 | high | いいえ | 高い推論強度 |
| 特高 | xhigh | いいえ | コーディング・エージェント用途の推奨帯 |
| 最大 | max | いいえ | GPT-5.6 / Codex 系の最上位ティア向け |
| ウルトラ | ultra | いいえ | 最上位。対応プロバイダーは限られる |
agent.reasoning_effort に保存される。未設定時の製品既定は 中(medium)。推論の深さは応答時間やコストに影響するため、用途に応じて調整する。
- 上位レベルの自動クランプ:
max/ultraは GPT-5.6 や Codex の最上位ティアを想定した値で、より小さいスケールしか持たないプロバイダーでは、そのプロバイダーの上限へ自動的にクランプされる(例: Anthropic 系はultraをmaxに、LM Studio はmax/ultraをxhighに、GLM-5.2 はxhigh/max/ultraをmaxに写像)。エラーにはならない。 - 手書きの無効化指定:
config.yamlにreasoning_effort: falseやdisabledを手書きした場合は「オフ(none)」として扱われ、画面では Off が選択された状態で表示される。
速度(サービスティア)
Section titled “速度(サービスティア)”適用中のモデルが対応するサービスティアに応じて、同じ Defaults ブロックの速度の表示が変わる。保存先は agent.service_tier(製品既定は空 ─ 通常速度)。
| モデルの対応 | 画面の表示 | 保存値 |
|---|---|---|
| Ultrafast に対応 | 「Speed」セレクト: Standard / 高速 / Ultrafast(「高速」は Fast 対応モデルのときだけ) | normal / fast / ultrafast |
| Fast のみ対応 | 「高速」トグル | fast / normal |
| どちらにも非対応 | 表示されない | ─ |
「Speed」「Standard」「Ultrafast」は日本語リソース未整備のため英語表示。CLI・TUI では /fast コマンドでも切り替えられる(スラッシュコマンド一覧)。
推論レベルの細粒度制御
Section titled “推論レベルの細粒度制御”推論レベルは、グローバル既定・モデル別・補助タスク別・MoA スロット別の階層で指定できる。グローバル既定は Defaults ブロック、補助タスク別は「補助モデル」の各タスクの「変更」で設定できる。モデル別と MoA スロット別は config.yaml の直接編集で設定する(画面に対応する入力欄はない)。
| 設定キー | 効く範囲 | 備考 |
|---|---|---|
agent.reasoning_effort | グローバル既定 | この画面の Defaults ブロックで設定 |
agent.reasoning_overrides | モデル別上書き | モデル名からレベルへの辞書。agent.reasoning_effort より優先。モデル名はドット・ハイフンなどの表記ゆれを許容してマッチする |
auxiliary.<タスク>.reasoning_effort | 補助タスク別 | none〜ultra。画面の「継承 · メインモデルの推論強度」を選ぶとキーを空(null)にして保存し、メインモデルの推論強度に従う |
moa.presets.<名前>.reference_models[].reasoning_effort / ...aggregator.reasoning_effort | MoA スロット別 | 「アドバイザーは深く考え、集約モデルは速く動く」のような使い分けができる |
agent: reasoning_effort: medium reasoning_overrides: gpt-5.6-sol: ultra claude-fable-5: xhighauxiliary: compression: reasoning_effort: lowagent.reasoning_overridesはキーにドットを含みうるため CLI コマンドからは設定できず、config.yamlを直接編集する。- GLM-5.2 のネイティブ制御: GLM-5.2 は API ネイティブの
reasoning_effort(high/maxの2段階)を持ち、Hermes の指定が実際にモデルへ届く(xhigh/max/ultraはmaxへ、それ以外の有効値はhighへ写像。無効化時と未指定時は送らない)。 - CLI・TUI では
/reasoning <レベル>でセッション限定の変更ができ、--globalを付けるとconfig.yaml(agent.reasoning_effort)へ永続化される。詳細は スラッシュコマンド一覧 を参照。
コンテキストウィンドウの上書き
Section titled “コンテキストウィンドウの上書き”| 画面表示(主) | 内部キー(サブ) | 製品既定値 | 推奨 |
|---|---|---|---|
| (ラベル位置に説明文。下記参照) | model_context_length | 0(自動) | 0 のまま |
入力欄のラベル位置には「メインのチャットモデルのみ、検出されたコンテキストウィンドウを上書きします(トークン数)。0 のままにすると、選択したモデルから検出された値を使用します。補助モデル/MoA モデルには影響しません。」という長い文が、その下に説明「0 のままにすると、選択したモデルから検出されたコンテキストウィンドウを使用します。」が表示される。日本語リソースでは、本来の短いラベル(英語版は「Main model context window (override)」)の位置に説明文が入っているため、このような見え方になる。
0 または空欄なら、選択モデルから検出した値を使う。上書きが効くのはメインのチャットモデルだけで、補助モデルとエージェントの協調(MoA)のモデルには影響しない。モデルの実際の上限より大きな値を手入力すると API エラーや早すぎる圧縮の原因になるため、通常は自動が安全。
| 画面表示(主) | 内部キー(サブ) | 製品既定値 | 推奨 |
|---|---|---|---|
| フォールバックモデル | fallback_providers | 空 | 必要時だけ追加 |
ページには「フォールバックモデル」の見出しと「デフォルトモデルが失敗したときに試す provider:model 形式のバックアップです。」という説明が表示される。
フォールバックモデルは 行追加式の構造化エディタで編集する。行ごとにプロバイダーとモデルをドロップダウンで選び、行の追加・削除で連鎖を編集する。上から順に、メインモデルが失敗した場合の代替として試される。
- プロバイダーとモデルの両方を選んだ行だけが保存される。片方だけの「半入力」行は画面に下書きとして残るが、設定には書き込まれない。
- 候補は接続済みプロバイダーのカタログから表示される(補助モデルのピッカーと同じ仕組み)。一覧に無いモデルは「カスタムモデル…」で ID を手入力できる。
config.yamlに手書きしたbase_urlやapi_modeなどの追加キーは、画面で編集しても保持される。- 行追加ボタン「Add fallback」など一部ラベルは、日本語リソース未整備のため英語で表示される。
config.yaml では fallback_providers がプロバイダーとモデルの組のリストになる。
fallback_providers: - provider: openrouter model: anthropic/claude-sonnet-5 - provider: gemini model: gemini-3-pro-preview旧形式の文字列指定も読み込み時には正規化されるが、新規設定は上記の構造化形式を使う。モデル名は実際にプロバイダーが公開している ID を使う。異なる会社のプロバイダーを組み合わせると障害分散になるが、料金、データ処理方針、ツール互換性は別途確認する。
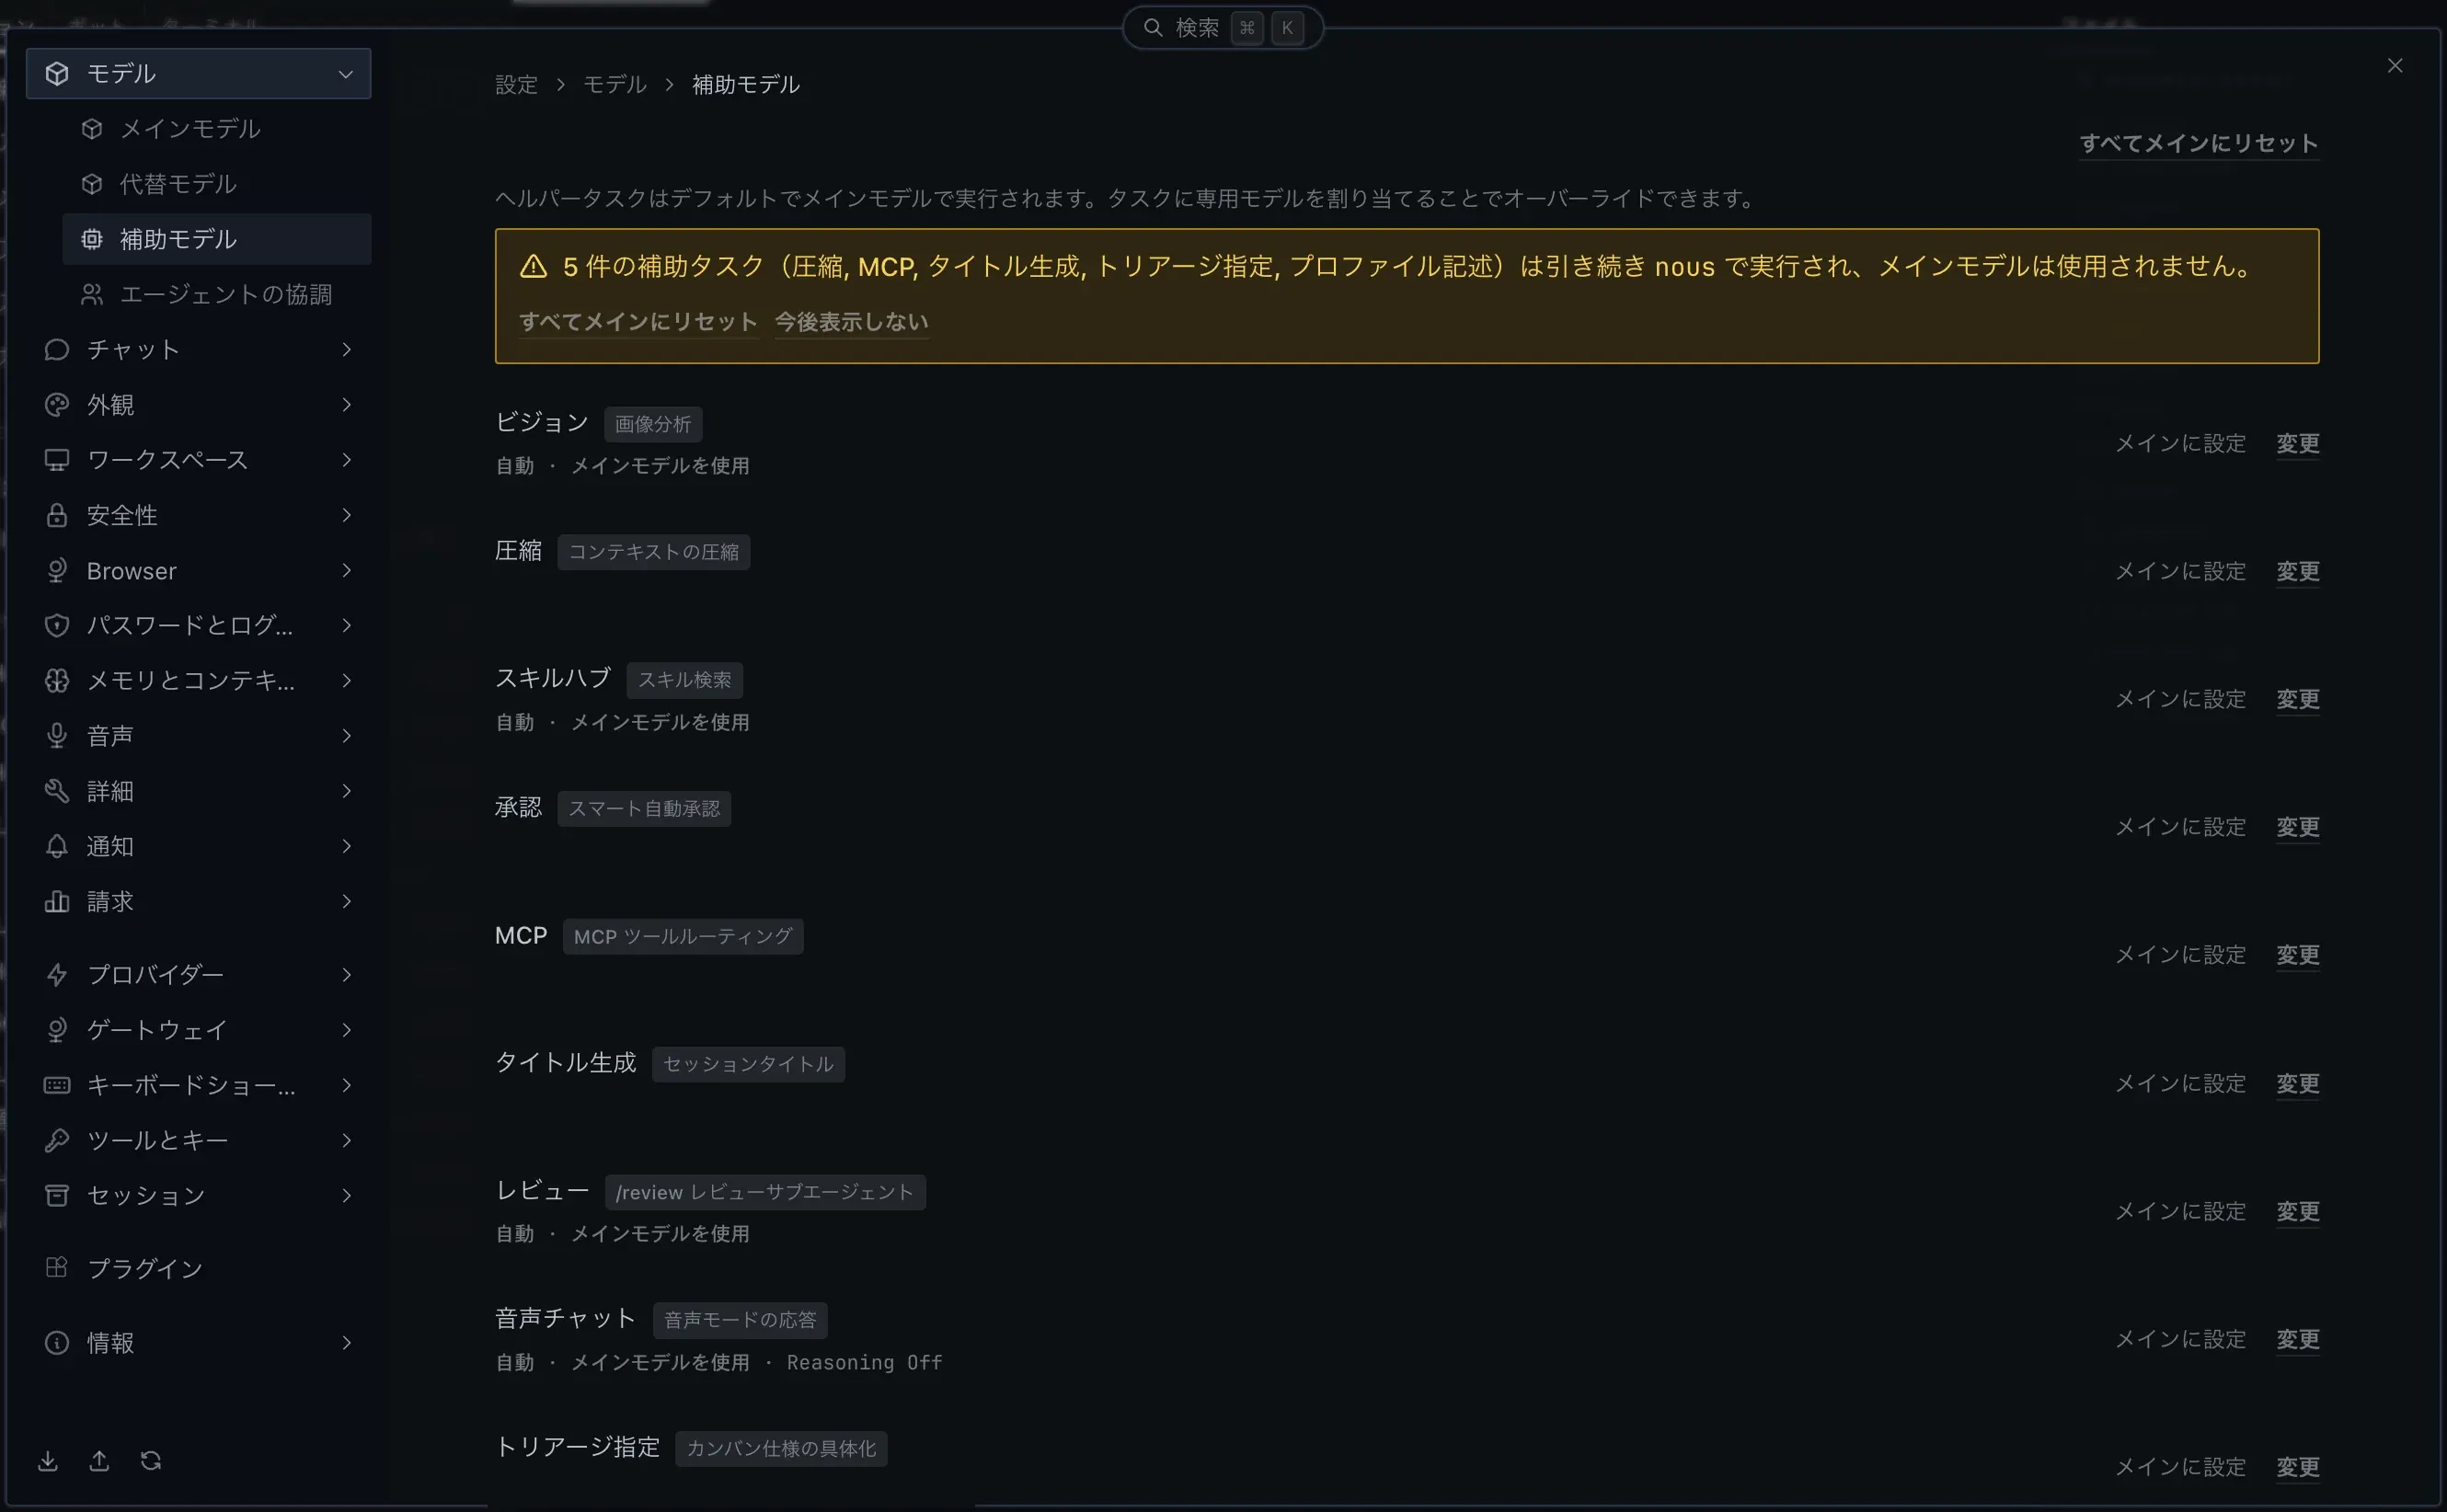
ページ冒頭には「ヘルパータスクはデフォルトでメインモデルで実行されます。タスクに専用モデルを割り当てることでオーバーライドできます。」と表示され、右上に「すべてメインにリセット」がある。
| 画面表示(主) | 内部キー(サブ) | 用途 | 製品既定値 | 推奨 |
|---|---|---|---|---|
| ビジョン | auxiliary.vision.provider / auxiliary.vision.model | 添付画像の分析や、画像をテキスト化する補助処理 | auto / 空欄 | メインが画像対応なら「メインに設定」 |
| 圧縮 | auxiliary.compression.provider / auxiliary.compression.model | 長い会話をコンテキストへ収めるための要約 | auto / 空欄 | 高速で指示追従性の高いモデル |
| スキルハブ | auxiliary.skills_hub.provider / auxiliary.skills_hub.model | スキルの検索、候補選定、関連性判断 | auto / 空欄 | メインで問題ない |
| 承認 | auxiliary.approval.provider / auxiliary.approval.model | smart 承認でコマンドの危険度を判定 | auto / 空欄 | 誤判定を避けるため高精度モデル |
| MCP | auxiliary.mcp.provider / auxiliary.mcp.model | MCP ツールの選択・ルーティング支援 | auto / 空欄 | ツール選択に強いモデル |
| タイトル生成 | auxiliary.title_generation.provider / auxiliary.title_generation.model | セッション内容から短いタイトルを生成 | auto / 空欄 | 安価な小型モデルで十分 |
| レビュー | auxiliary.review.provider / auxiliary.review.model | /review で起動するレビューサブエージェント | auto / 空欄 | コードレビューに強い高精度モデル |
| 音声チャット | auxiliary.voice_chat.provider / auxiliary.voice_chat.model | 音声モードの応答 | auto / 空欄(推論強度は none) | 応答の速いモデル |
| トリアージ指定 | auxiliary.triage_specifier.provider / auxiliary.triage_specifier.model | カンバンの仕様の具体化 | auto / 空欄 | メインで問題ない |
| カンバン分解 | auxiliary.kanban_decomposer.provider / auxiliary.kanban_decomposer.model | カンバンのタスク分解 | auto / 空欄 | メインで問題ない |
| プロファイル記述 | auxiliary.profile_describer.provider / auxiliary.profile_describer.model | プロファイル概要の自動生成 | auto / 空欄 | 安価な小型モデルで十分 |
| キュレーター | auxiliary.curator.provider / auxiliary.curator.model | 使用したスキルの有用性レビューや整理 | auto / 空欄 | メインまたは高精度モデル |
画面の並びは上表のとおりの 12 件(ビジョン / 圧縮 / スキルハブ / 承認 / MCP / タイトル生成 / レビュー / 音声チャット / トリアージ指定 / カンバン分解 / プロファイル記述 / キュレーター)。各行には用途の短い説明(例: 「画像分析」「タスク分解」)が添えられる。ウェブ抽出用のスロットは存在せず、ページ本文の抽出はメインモデルまたは各検索バックエンド側で行われる。既定では全タスクがメインモデルを自動使用する。個別に「変更」で固定でき、「すべてメインにリセット」で解除できる。
- プラグイン由来のタスク: 補助タスクを登録するプラグインを入れていると、そのタスクが 12 件の後ろに並ぶ。別のタスクの設定を引き継ぐ種類のタスクは「(タスク名) を継承」と経路付きで表示され、独自に固定している場合は「(タスク名) に従う」ボタンで継承に戻せる。
auxiliary.monitor(メール監視の重要度分類に使う補助スロット)は config スキーマ上は存在するが、この画面には表示されない。
補助モデルの各操作
Section titled “補助モデルの各操作”| 画面表示(主) | 内部値・処理(サブ) | 動作 |
|---|---|---|
| 自動 · メインモデルを使用 | provider: auto, model: "" | タスク専用の上書きがなく、現在のメインモデルへ追従 |
| メインに設定 | 対象の provider を auto、model を空文字へ変更 | 選択タスクの上書きを解除してメインへ戻す |
| 変更 | 対象の auxiliary.<task>.provider / .model | タスク専用のプロバイダーとモデルを選ぶ |
| (プロバイダーのデフォルト) | model: "" | モデルを固定せず、そのプロバイダーの標準モデルへ委ねる |
| Reasoning(「変更」の中) | auxiliary.<task>.reasoning_effort | タスクごとの推論強度。既定は「継承 · メインモデルの推論強度」。ほかに Off と各推論レベルを選べる |
| すべてメインにリセット | 全補助タスクへ provider: auto, model: "" | 全タスクの上書きを一括解除 |
固定済みのタスクは「(モデル名) · Reasoning Off」のように、モデルと推論強度が並んで表示される(「Reasoning」は日本語リソース未整備のため英語表示)。
タスクへプロバイダーとモデルを割り当てると、そのプロバイダーのエンドポイント(base_url)も一緒に保存される。ユーザー定義プロバイダーや独自エンドポイントへ補助タスクを割り当てた場合も、呼び出し先が欠落せずに解決される。
エージェントの協調
Section titled “エージェントの協調”Mixture of Agents(MoA)は仮想モデルプロバイダー。複数モデルの視点を集約して、難しいタスクの精度を上げる。名前を付けた MoA プリセットを作ると、moa プロバイダー配下の選択可能なモデルとして各モデルピッカーに現れる。
MoA プリセットを選ぶと、プリセットの 集約モデル(aggregator) が実際の応答を書き、ツール呼び出しを出す。参照モデル(reference models) が先に走り、その分析を集約モデルへ渡す。通常のエージェントループ(ツール呼び出し・反復・割り込み・履歴保存・同一セッションの文脈)はそのまま働く。
ページの説明文にあるとおり、集約モデルがツールループのすべての処理を行うため、実行費用のほぼ全額が集約モデルのプロバイダーに請求される。参照モデルは既定でユーザーの各ターンに一度だけ助言する。
デスクトップでの選択・作成
Section titled “デスクトップでの選択・作成”| 操作 | 場所 | 動作 |
|---|---|---|
| プリセットへ切り替え | モデルドロップダウンの MoA presets セクション | 選ぶと MoA: <プリセット名> へメインモデルが切り替わる |
| プリセットの作成・編集 | 設定 > モデル > エージェントの協調 | 参照モデルと集約モデルの組み合わせを作成・編集する |
作成・編集画面の主な操作は次のとおり。見出しは「エージェント混合(Mixture of Agents)」。
| 画面表示 | 動作 |
|---|---|
| プリセット(セレクト) | 編集するプリセットを選ぶ |
| 有効 | プリセットの有効・無効(enabled) |
| デフォルトに設定 / 削除 | 選択中のプリセットを既定にする / 削除する(プリセットが 1 つだけのときは削除できない) |
| 新しいプリセット + プリセットを追加 | 名前を入れて新規プリセットを作る |
| デフォルト: (名前) | 現在の既定プリセット名 |
| 参照 N(バッジ「既定では各ターンに一度だけ助言」) | 参照モデルのプロバイダーとモデルを選ぶ。右のトグルでこの参照だけ有効・無効(reference_models[].enabled)、「削除」で行を消す |
| 参照モデルを追加 | 参照モデルの行を足す |
| 集約モデル(バッジ「実行モデル · 実行費用の請求先」) | 集約モデルのプロバイダーとモデルを選ぶ |
参照モデルはトグルで行を削除せずに外せるため、プリセットの構成を壊さずに一部の参照モデルだけ試験的に無効化できる。参照・集約のモデル欄でも「カスタムモデル…」で ID を手入力できる。雛形プリセット default(参照: OpenAI Codex gpt-5.5 / OpenRouter deepseek/deepseek-v4-pro、集約: OpenRouter anthropic/claude-opus-4.8)が最初から入っており、既定プリセットに設定されている。
手動の保存ボタンはなく、編集内容は自動保存される。
- スロット(参照・集約)の変更は、編集が止まってから 600 ミリ秒後に自動保存される。
- プリセット単位の操作(デフォルトに設定 / プリセットを追加 / 削除)はクリック時に即保存される。
- プロバイダーだけ選んでモデルが未選択の「半入力」スロットがある間は、保存が保留される。バックエンドが不完全なプリセットを HTTP 422 で拒否する仕様のため、UI は入力の完了を待ち、スロットが埋まった時点でプリセット全体をまとめて保存する。保留中もディスク上には直前の完全な設定が残る。
MoA はモデルシステム上の通常プロバイダーなので、/goal・ゲートウェイセッション・TUI・デスクトップチャットと自動的に組み合わさる。
/moa ─ 単発ショートカット
Section titled “/moa ─ 単発ショートカット”/moa <プロンプト> は、既定の MoA プリセットで1回だけ実行し、終わったら元のモデルへ戻す単発コマンド。引数全体がプロンプトとして扱われ、セッションのモデルは変わらない。セッション全体を MoA プリセットに切り替えたい場合は、モデルピッカーから選ぶ(/moa はモデルを切り替えない設計)。
設定(config.yaml)
Section titled “設定(config.yaml)”moa 配下に名前付きプリセットを持つ。プロバイダー/モデルのペアを明示するので、異なる会社のプロバイダーを混在できる。
moa: default_preset: default presets: default: reference_models: - provider: openai-codex model: gpt-5.5 reasoning_effort: high # スロット別の推論レベル(任意) - provider: openrouter model: deepseek/deepseek-v4-pro enabled: false # このスロットだけ外す(行は残る) aggregator: provider: openrouter model: anthropic/claude-opus-4.8 reasoning_effort: low # 集約モデルは速く、なども可能 fanout: user_turn # または per_iteration / every_n:3 enabled: trueターミナルからは hermes moa list / hermes moa configure [name] / hermes moa delete <name> で管理する。
製品既定値には雛形プリセット default(default_preset: default)が含まれる。プリセット単位の主な設定キーは次のとおり。
| キー | 既定 | 内容 |
|---|---|---|
reference_temperature / aggregator_temperature | 未設定(送らない) | 既定では temperature を API に送らず、プロバイダー既定に従う(単一モデル動作と同じ)。数値を書いた場合だけ送信される |
reference_timeout | 未設定 | 参照モデル 1 回あたりのタイムアウト(秒)。未設定なら auxiliary.moa_reference.timeout(既定 900)を使う |
degraded_reference_policy | loud | 参照モデルが失敗したときの開示方針。loud / silent |
fanout | user_turn | 参照モデルを走らせる頻度。user_turn はユーザーターンごとに1回だけ実行し、以降のツールループは集約モデル単体で進む(最も低コスト)。per_iteration はツール反復のたびに再実行し、助言が作業状態に追従する(参照モデルの費用と遅延が反復回数ぶん増える)。every_n:<N>(N は 2 以上)は各ターンの最初の反復と、以降 N 回ごとに実行する中間の設定 |
reference_models[].reasoning_effort / aggregator.reasoning_effort | 未設定 | スロット別の推論レベル(前述の「推論レベルの細粒度制御」を参照) |
enabled | true | false で参照の分散を止め、集約モデル単体で動く |
トレース保存は moa.save_traces(既定 false)と moa.trace_dir で制御する。
- 集約モデルに別の MoA プリセットは指定できない(再帰は禁止)。仮想プロバイダーは参照・集約スロットに指定できない。
- 一部の参照モデルが認証失敗しても、そのターンは中断せず、返ってきたモデルだけで続行する。
- MoA はモデル呼び出し回数を増やす(1反復で複数の参照呼び出し+集約呼び出し)。ただしメイン会話のプロンプトキャッシュは壊さない設計。
- プリセットに
enabled: falseを設定すると参照の分散は止まり、集約モデル単体で動く(プリセットごとのオフスイッチ)。 hermes toolsの一覧には出ない(有効化するツールセットではない)。
- まずメインモデルだけを設定する。
- 補助モデルは速度・費用の問題が確認できたタスクだけ分離する。
- コンテキストウィンドウは自動検出にする。
- 業務継続が必要な場合だけ、別プロバイダーのフォールバックを1~2個登録する。
- 難しいタスクで精度が要る場面だけ、MoA プリセットを試す。通常のタスクは単一モデルで足りる。
- 推論レベルはグローバル既定(中)で運用を始め、特定モデル・特定タスクで過不足が出たときだけ
agent.reasoning_overridesや補助タスク別・MoA スロット別の指定で調整する。
© 2026 Hermes Desktop ガイド(非公式)。引用・部分転載は、出典として本ページへのリンクを添えていただければ歓迎します。記事全文の無断複製・転載はご遠慮ください。